「1時間近い会議や研修を、あとから議事録にまとめるのが大変」
この作業をAIに任せたら、どこまで実用的な議事録を作れるのでしょうか。
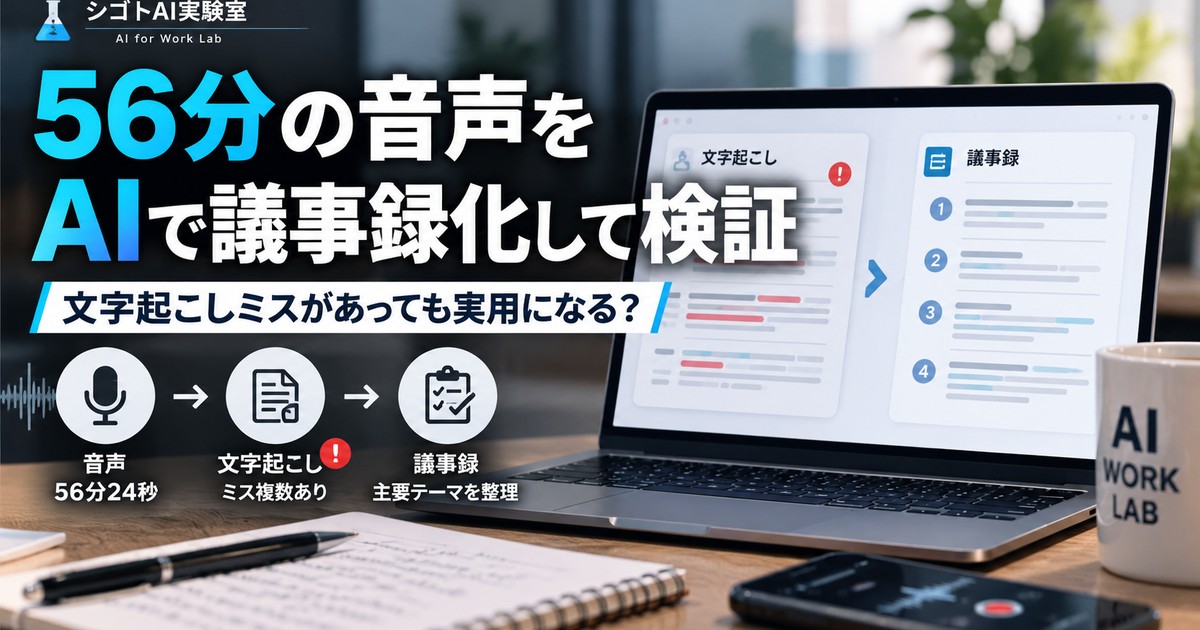
今回は、実際に行われた56分24秒の社内研修音声を使って検証しました。
音声をAIで文字起こしし、そのデータから議事録を作成。さらに文字起こしと議事録を照合し、抜け・誤認・推測がないかチェックします。
なお、実際の研修内容・人物名・店舗名・具体的な会話などの内部情報は公開せず、この記事ではAI処理の結果だけを紹介します。
今回の実験結果
結論から言うと、文字起こしには複数の認識ミスがありましたが、不確かな情報を推測させないことで、主要な内容を整理した議事録を作ることができました。
今回の結果は以下です。
| 項目 | 結果 |
|---|---|
| 元音声 | 56分24秒 |
| 監査で抽出した主要テーマ | 12テーマ |
| 議事録に含まれていた主要テーマ | 12 / 12 |
| 文字起こしとの照合で確認できた明確な架空情報 | 0件 |
| 主要テーマの大きな抜け | 0件 |
| 不明な発言者の断定 | 回避 |
| 文字起こしで要確認となった箇所 | 複数あり |
ただし、これは「AIだけで完全な議事録が作れる」という結果ではありません。
今回特に見えてきたのは、文字起こしと議事録作成では、注意すべきポイントが違うということでした。
まず56分24秒の音声を文字起こし
今回の元データは、約56分の社内研修音声です。
いきなり音声から完成版の議事録を作るのではなく、
- 音声を文字起こしする
- 文字起こしをもとに議事録を作る
- 文字起こしと議事録を照合する
という3段階で検証しました。
文字起こしにはDescriptを使用し、その文字データをもとにAIで議事録を整理しています。
この方法にした理由は、あとから「元の文字起こしにない内容をAIが追加していないか」を確認しやすくするためです。
文字起こしには複数のミスがあった
実際の文字起こしを確認すると、精度は100%ではありませんでした。
確認できたのは、
- 人名や固有名詞の表記揺れ
- 不自然な数字
- 金額の一部が欠落したと思われる箇所
- 文脈と関係のない外国語への誤変換
- 聞き取りにくい会話の不自然な文章化
などです。
特に、人名・固有名詞・金額・日時・数字は、そのまま正しい情報として扱わない方が安全だと感じました。
AI文字起こしは非常に便利ですが、「文字になった=正しい」と考えるのは危険です。
文字起こしミスを議事録に引き継がないようにした
今回、議事録を作成する際に重要視したのが、
「不明な情報を推測して補わない」
というルールです。
例えば、文字起こしされた数字が明らかに不自然でも、「たぶん○○だろう」と補完して議事録には入れません。
人名についても、発言者を確実に判別できない場合は「○○さんが発言した」と断定しないようにしました。
この状態で文字起こしと議事録を照合したところ、文字起こしに存在しない明確な新事実の追加は確認できませんでした。
ここは今回の実験で特に重要だったポイントです。
AIに単純に「読みやすい議事録にして」と頼むだけでなく、
「判断できない情報は書かない」
という条件を入れることで、文字起こしの誤認識がそのまま議事録の誤情報になるリスクを下げられそうです。
56分の内容を12テーマに整理
文字起こし全体を監査したところ、内容は大きく12のテーマに分類できました。
その12テーマと生成された議事録を照合すると、12テーマすべてに対応する内容が議事録内に含まれていました。
約1時間の文字起こしを最初から読み返す場合、必要な情報を探すだけでも手間がかかります。
一方、議事録では話題ごとに内容が整理されるため、
「何が話されたのか」
「重要なポイントは何か」
「どこを確認すべきか」
を追いやすくなりました。
今回の結果を見る限り、長い会話を分類・要約・構造化する作業はAIと相性が良いと感じます。
それでも人間が確認した方がいい7項目
今回の検証から、AI議事録を業務で使う場合でも、次の情報は人間が確認した方がよさそうです。
- 人名
- 固有名詞
- 金額
- 日時
- 数字
- 発言者
- 重要な決定事項
逆に、
- 話題の分類
- 長い会話の要約
- 重複内容の整理
- 見出しへの分解
- 読みやすい文章への整形
などは、AIに任せやすい作業でした。
そのため現時点では、
AIに「整理・要約」を任せ、人間が「重要情報の正確性」を確認する
という役割分担が現実的だと考えています。
今回は時間短縮率を出さない
前回の「ChatGPTで月報作成」の実験では、比較用ベンチマークを使って時間短縮率を算出しました。
しかし今回は、あえて「○%短縮」という数字を出しません。
実験途中で音声ファイルのアップロード方法やツール接続の確認が発生したため、純粋な文字起こし・議事録作成時間を正確に計測できなかったからです。
この状態で「○分短縮できた」と書いてしまうと、実測結果ではなくなってしまいます。
次回同じ実験を行う際は、
音声アップロード開始 → 文字起こし完了 → 議事録生成完了 → 人間による最終確認完了
までをそれぞれ計測します。
今回の実験でわかったこと
今回特に興味深かったのは、
文字起こしにミスがあっても、そのミスをそのまま議事録へ持ち込まない方法がある
という点です。
文字起こしそのものには複数の誤認識がありました。
しかし、不確かな情報を推測しない条件を付け、主要な内容を中心に整理することで、文字起こしとの照合では明確な架空情報の追加を確認せずに議事録化できました。
一方、人名や数字、固有名詞などを含めて完全な正確性を求める場合は、人間による原音確認が必要です。
今回の実験からは、
AI:文字起こし・分類・要約・構造化
人間:重要情報の確認・最終判断
という分担が、実務では使いやすそうだという結果になりました。
シゴトAI実験室では今後も、「AIならできそう」で終わらせず、実際の業務データを使ってどこまで任せられるのかを検証していきます。
コメント